
Cada vez que alguien me pregunta "¿debería hacer fine-tuning o montar un RAG?" sospecho que la pregunta está mal planteada. No suelen competir. Resuelven problemas distintos, y tratarlos como dos opciones de una misma lista es lo que lleva a elegir mal.
Qué resuelve cada técnica realmente
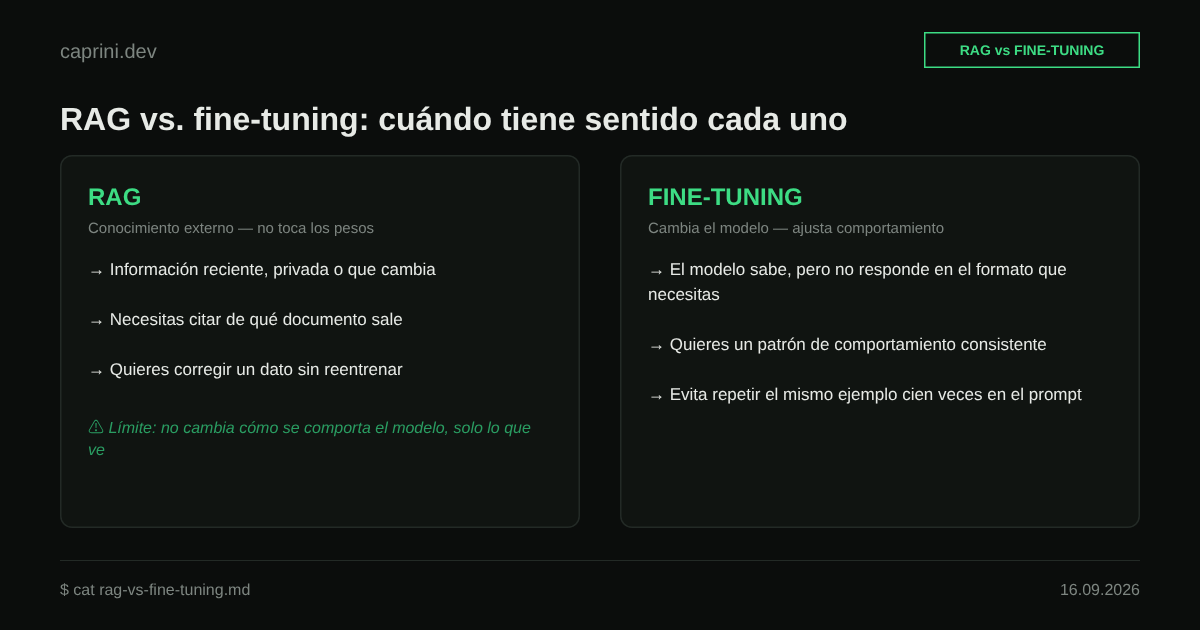
RAG (retrieval-augmented generation) le da al modelo acceso a información externa en el momento de responder. No toca los pesos del modelo: cambia lo que el modelo ve antes de generar la respuesta. Buscas los documentos relevantes, los metes en el prompt, y el modelo responde con esa información delante.
Fine-tuning cambia el modelo en sí. Ajustas sus pesos con ejemplos adicionales para que se comporte de una forma concreta de manera consistente, sin que tengas que pedírselo cada vez en el prompt.
Dicho así, ya se ve el problema de plantearlo como disyuntiva: uno añade conocimiento externo, el otro moldea comportamiento. No son sustitutos.
La pregunta que de verdad hay que hacerse
No es "cuál es mejor", es: ¿el problema que tengo es de conocimiento o de comportamiento?
Si el modelo no sabe algo, porque es información reciente, privada, o cambia con frecuencia, ningún fine-tuning lo arregla de forma sostenible. Vas a tener que reentrenar cada vez que cambien los datos, lo cual es exactamente lo que RAG evita: ahí actualizas el documento, no el modelo.
Si el modelo ya tiene el conocimiento pero no responde en el formato que necesitas, o no sigue un patrón de comportamiento consistente por mucho que se lo expliques en el prompt, ese es un problema de comportamiento. Meter el mismo ejemplo en el prompt cien veces no es una solución, es un parche caro en tokens.
Cuándo RAG se queda corto
- El problema no es de datos sino de comportamiento repetido: un formato estricto, un tono concreto, seguir un esquema sin desviarse. Inyectar ejemplos en cada prompt es frágil y encarece cada llamada.
- Necesitas latencia baja y no puedes permitirte el paso extra de recuperación antes de generar.
- El conocimiento no cambia, ya es grande y estable, y "recordarlo siempre en el prompt" es peor que haberlo interiorizado.
Cuándo fine-tuning se queda corto
- Los datos cambian con frecuencia. Cada actualización real exige reentrenar o el modelo queda obsoleto, y eso sale caro rápido para un equipo pequeño.
- Necesitas trazabilidad: poder señalar de qué documento viene una afirmación. Fine-tuning no te da eso, RAG sí, porque puedes citar la fuente recuperada.
- Quieres poder corregir un dato erróneo sin tocar el modelo. En RAG, editas el documento. En fine-tuning, tienes que volver a entrenar.
La combinación, no la disyuntiva
En la práctica, la respuesta suele ser RAG para el conocimiento más un ajuste ligero, o simplemente un buen system prompt, para el comportamiento. El fine-tuning completo de un modelo grande rara vez es la primera opción sensata para un equipo pequeño: el coste de mantenerlo, y de repetir el proceso cada vez que cambia el modelo base que usas, es alto comparado con mantener una base documental que solo hay que actualizar.
Mi criterio por defecto
Para un equipo sin infraestructura dedicada a reentrenar modelos, empiezo siempre por RAG. Es más barato de iterar, más fácil de depurar (puedes ver exactamente qué documento se recuperó y por qué la respuesta salió así) y no te ata a una versión concreta del modelo base.
Solo planteo fine-tuning cuando tengo datos de uso real que demuestran que el problema es de comportamiento, no de conocimiento, y que ese comportamiento no se puede resolver con un prompt mejor escrito. Es la misma lógica que aplico para no optimizar código antes de tener un problema de rendimiento medido: no se ajustan pesos de un modelo por intuición, se ajustan cuando el prompt ya no basta y lo puedes demostrar.
Relacionado: Qué es un ADR y por qué lo uso incluso en proyectos pequeños