
La primera vez que monté un RAG me pasé una tarde entera comparando bases de datos vectoriales antes de escribir una sola línea que buscara nada. Con cien documentos. Eso es sobreingeniería en estado puro: resolver un problema de escala que no tenía todavía.
Un RAG sencillo, para un proyecto pequeño, se monta con muchísimo menos de lo que parece.
El pipeline mínimo que necesitas
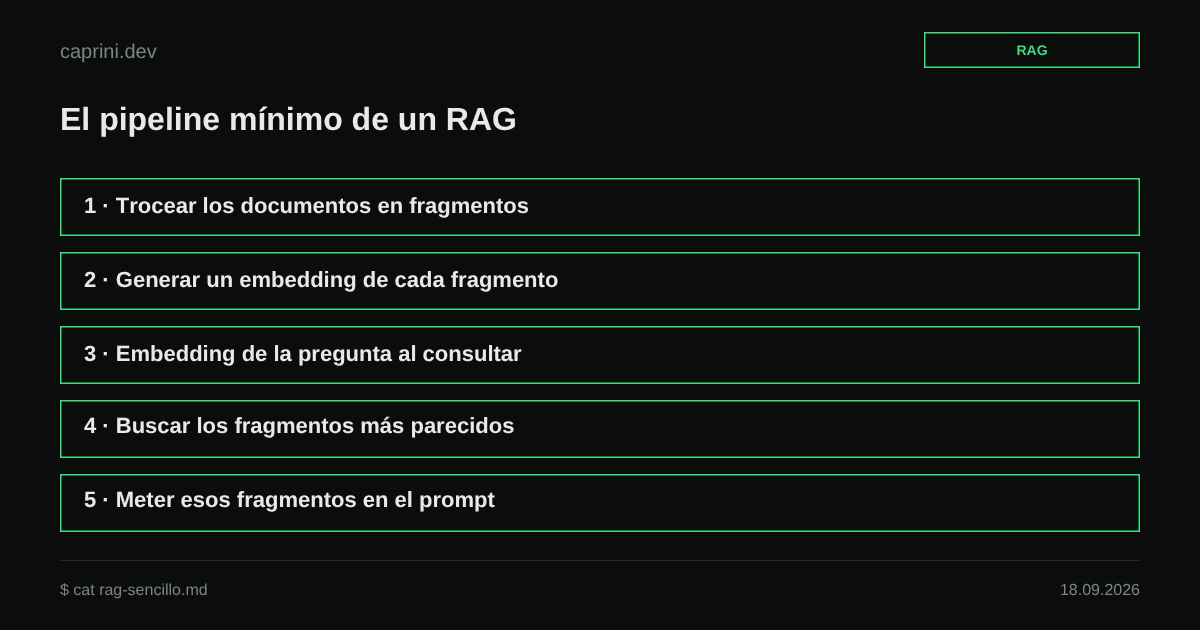
Da igual el framework que uses, el flujo es siempre el mismo:
- Trocear los documentos en fragmentos (chunks).
- Generar un embedding de cada fragmento y guardarlo.
- En el momento de la consulta, generar el embedding de la pregunta.
- Buscar los fragmentos más parecidos a esa pregunta.
- Meter esos fragmentos en el prompt junto con la pregunta y dejar que el modelo responda.
Eso es todo. No hace falta nada más para tener un RAG funcional. Todo lo que se añade encima, reranking, búsqueda híbrida, agentic RAG con varios pasos de recuperación, es una mejora sobre este esqueleto, no un requisito para que funcione.
Trocear documentos: el chunking importa más que el algoritmo
El paso que más impacto tiene en la calidad, y el que menos atención suele recibir, es cómo trocear el texto. Dos reglas que uso siempre:
- Respeta los límites semánticos cuando puedas: mejor cortar entre párrafos o secciones que a la mitad de una frase. Un fragmento que empieza a mitad de una idea produce una recuperación peor, aunque el embedding sea técnicamente correcto.
- Que cada fragmento tenga sentido por sí solo. Si necesitas leer el fragmento anterior para entender el actual, el modelo que reciba solo ese trozo tampoco lo va a entender.
No hace falta un algoritmo de chunking sofisticado para empezar. Trocear por párrafos o por secciones con encabezado ya cubre la mayoría de los casos de un proyecto pequeño.
No necesitas una base de datos vectorial dedicada para empezar
Esta es la parte donde más gente sobreconstruye. Si tu corpus tiene unos cientos o pocos miles de fragmentos, una búsqueda lineal en memoria, comparando el embedding de la pregunta contra todos los guardados con similitud de coseno, es perfectamente viable y responde en milisegundos. No necesitas montar un servicio de base de datos vectorial dedicado para eso.
Lo que sí necesitas es un sitio donde guardar los embeddings junto con el texto original y algo de metadata (de qué documento viene, en qué posición). Con eso basta para reconstruir la respuesta y, si quieres, citar la fuente.
La base de datos vectorial dedicada empieza a justificarse cuando el corpus ya no cabe cómodo en memoria, cuando necesitas actualizaciones incrementales frecuentes sin recalcular todo, o cuando necesitas filtrar por metadata de forma eficiente. Ninguna de esas tres cosas suele ser cierta el primer día.
Qué meter en el prompt y qué no
Recuperar los fragmentos es solo la mitad del trabajo. La otra mitad es no volcarlos todos en el prompt sin criterio.
- Limita el número de fragmentos que envías. Meter demasiados diluye la relevancia y encarece cada llamada sin mejorar la respuesta.
- Incluye la fuente de cada fragmento junto al texto, aunque solo sea internamente, para poder verificar después de dónde salió una afirmación.
- Si un fragmento recuperado tiene una similitud muy baja respecto a la pregunta, mejor descartarlo que forzarlo en el contexto. Un fragmento irrelevante no ayuda, distrae al modelo.
Señales de que sí necesitas más sofisticación
La sobreingeniería no es añadir complejidad, es añadirla antes de necesitarla. Las señales de que sí toca dar el siguiente paso son concretas:
- La búsqueda por similitud pura empieza a devolver resultados poco relevantes de forma consistente (ahí es cuando reranking aporta).
- El corpus ha crecido lo suficiente como para que la búsqueda lineal en memoria se note en latencia o en consumo de recursos.
- Necesitas combinar búsqueda semántica con filtros exactos (por fecha, por categoría, por autor), que una búsqueda vectorial pura no resuelve bien sola.
Hasta que no veas una de esas señales con datos reales, no con la sospecha de que "en algún momento hará falta", el pipeline mínimo es la decisión correcta. Es más fácil añadir complejidad cuando el problema la justifica que quitarla cuando nunca hizo falta.
Relacionado: Por qué planificar antes de programar no es perder el tiempo